


Erreurs de prédiction
Erreurs de prédiction signées et non signées
Apprentissage et mémoire

Les erreurs de prédiction signées et non signées interviennent dans l'apprentissage associatif et la mémoire épisodique, notamment en modulant les associations, l'attention et l'encodage mnésique.
Les erreurs de prédiction (PE : Prediction error) signées et non signées interviennent dans différents mécanismes d'apprentissage et de mémoire.
- Les erreurs signées permettent notamment d'ajuster les associations entre les stimuli, les actions et leurs conséquences en fonction du sens et de l'amplitude des écarts entre les résultats attendus et observés.
- Les erreurs non signées peuvent, quant à elles, moduler l'attention accordée aux stimuli en fonction de leur caractère inattendu.

Les erreurs de prédiction motivationnelles et les structures cérébrales impliquées dans leur traitement sont développées dans une page spécifique.
Ces mécanismes interviennent notamment :
- dans l'apprentissage associatif, où les erreurs de prédiction contribuent à modifier les associations et à orienter l'attention,
- dans la mémoire épisodique, où elles influencent l'encodage des événements en fonction des résultats obtenus et des conditions dans lesquelles les individus effectuent leurs choix.
Erreurs de prédiction signées et non signées dans l'apprentissage associatif
Vue d'ensemble
Dans l'apprentissage associatif, les erreurs de prédiction (PE) permettent de modifier les associations entre les stimuli, les actions et leurs conséquences en fonction des écarts entre les résultats attendus et observés.
Cependant, leur rôle diffère selon les modèles d'apprentissage.
1. Les modèles classiques du conditionnement associatif décrivent comment les associations entre stimuli sont acquises et modifiées, ainsi que le rôle de l'attention dans cet apprentissage.
Comment un organisme apprend-il à associer des stimuli ?
- Le modèle de Rescorla-Wagner utilise les erreurs de prédiction signées pour modifier directement la force des associations.
- Les modèles de Pearce-Hall et de Mackintosh prennent respectivement en compte l'amplitude des erreurs de prédiction (erreurs de prédiction non signées) et la valeur prédictive des stimuli pour moduler l'attention et faciliter les apprentissages ultérieurs (Surprise! Neural Correlates of Pearce-Hall and Rescorla-Wagner Coexist within the Brain 2013).
2. Les algorithmes d'apprentissage par renforcement (RL, Reinforcement Learning) étudient plus particulièrement comment les conséquences des actions permettent d'apprendre leurs valeurs et de guider les choix futurs.
Comment un agent apprend-il à choisir ses actions pour obtenir des récompenses ?
Les méthodes d'apprentissage par différence temporelle (TD) utilisent également les erreurs de prédiction pour actualiser les valeurs estimées, en tenant compte des récompenses futures.
- Elles sont employées dans des algorithmes sans modèle comme Q-learning et SARSA.
- Les modèles de Rescorla-Wagner et les méthodes TD reposent ainsi sur un principe commun d'actualisation par erreur de prédiction, mais ils s'appliquent à des problèmes d'apprentissage différents.
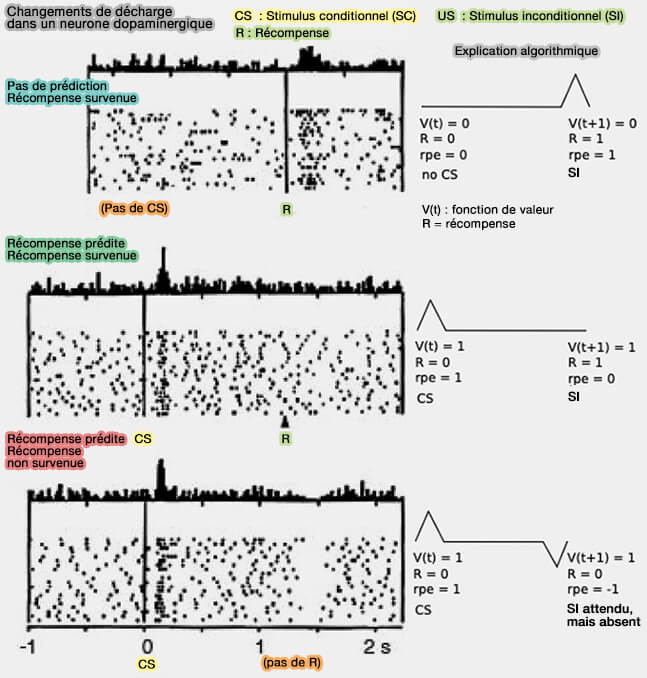
(Figure : vetopsy.fr d'après Schultz)
Les mécanismes dopaminergiques associés aux erreurs de prédiction de récompense (RPE) sont étudiés dans un chapitre spécifique.
Modèle de Rescorla-Wagner (1972)
Le modèle de Rescorla-Wagner (RW), datant de 1972, est un modèle mathématique du conditionnement classique, dans lequel les modifications de la force associative dépendent d'une erreur de prédiction signée.
Ce principe se retrouve dans les modèles d'apprentissage par différence temporelle (TD), qui actualisent les valeurs prédites à partir des erreurs de prédiction.
Équation et principe
Prenons l'exemple du conditionnement classique de Pavlov, dans lequel un chien apprend à associer une sonnerie à la présentation de nourriture, pour mieux comprendre les différents termes de cette équation.
1. Dans le modèle de Rescorla-Wagner, la modification de la force associative est exprimée par l'équation suivante, qui fait intervenir l'écart entre le résultat attendu et le résultat obtenu.
$\Delta V=\alpha\beta(\lambda-\sum V)$
- $\Delta V$ représente la modification de la force associative du stimulus conditionnel (SC), par exemple, l'augmentation ou la diminution de l'association entre une sonnerie et la présentation de nourriture.
- $\alpha$, compris entre 0 et 1, représente l'associabilité du stimulus conditionnel, c'est-à-dire sa capacité à entrer dans une association.
Ce paramètre dépend notamment de la nature et de la saillance du stimulus, par exemple une sonnerie plus ou moins perceptible.
- $\beta$, compris entre 0 et 1, représente le paramètre d'apprentissage associé au stimulus inconditionnel (SI), qui détermine, avec $\alpha$, l'importance de la modification associative produite par une erreur de prédiction.
Dans ce modèle, le taux d'apprentissage correspond au produit $\alpha\beta$ et leur produit détermine la proportion de l'erreur de prédiction (PE) utilisée pour modifier la valeur associative.
- $\lambda$ représente la valeur associative maximale soutenue par le stimulus inconditionnel, généralement comprise entre 0 et 1 lorsque les valeurs sont normalisées.
- Dans notre exemple de Pavlov, $\lambda=1$ lorsque la nourriture est présentée. Il s'agit de la valeur maximale que peut atteindre la prédiction de nourriture lorsque celle-ci est parfaitement annoncée par les stimuli conditionnels.
- En revanche, $\lambda=0$ lorsque la nourriture attendue n'est pas présentée.
- $\sum V$ représente la somme des forces associatives des stimuli conditionnels présents, c'est-à-dire la valeur totale de la prédiction du résultat produite par ces stimuli.
- Dans notre exemple de Pavlov, si une sonnerie et une lumière sont présentées ensemble, leurs forces associatives s'additionnent pour déterminer dans quelle mesure elles prédisent l'arrivée de nourriture.
- Par exemple, si la sonnerie possède une force associative de 0,8 et la lumière de 0,2, alors $\sum V=1$. La nourriture est donc entièrement prédite par les deux stimuli réunis.
- $(\lambda-\sum V)$ représente l'erreur de prédiction signée, c'est-à-dire l'écart entre la valeur associative soutenue par le stimulus inconditionnel et la prédiction totale des stimuli conditionnels présents.
Si la sonnerie prédit déjà parfaitement la nourriture, cet écart est nul.
2. Lorsque le résultat obtenu diffère du résultat attendu, une erreur de prédiction $(\lambda-\sum V)$ entraîne une modification de la force associative $(\Delta V)$ entre les stimuli et ce résultat.
- Plus la valeur absolue de l'erreur $(\lambda-\sum V)$ est importante, plus elle se rapproche de 1 dans notre exemple normalisé, plus la modification associative peut être importante.
Cette modification dépend également de l'associabilité du stimulus conditionnel $(\alpha)$ et du paramètre d'apprentissage associé au stimulus inconditionnel $(\beta)$.
- En revanche, lorsque l'erreur est nulle, aucune modification ne se produit.
3. Le signe de l'erreur détermine le sens de cette modification.
- Une erreur positive apparaît lorsque le résultat est supérieur à celui qui était attendu (RPE positive) et entraîne une augmentation de la force associative.
Dans notre exemple, elle peut atteindre $+1$ lorsque la nourriture est présentée alors qu'elle n'était pas prédite.
- Une erreur négative apparaît lorsque le résultat est inférieur à celui qui était attendu (RPE négative) et entraîne une diminution de la force associative.
Elle peut atteindre $-1$ lorsque la nourriture était parfaitement prédite, mais n'est pas présentée.
Blocage et surattente
Le modèle de Rescorla-Wagner permet notamment d'expliquer deux phénomènes.
1. Le phénomène de blocage se produit lorsqu'un stimulus déjà appris prédit entièrement une récompense et empêche, ou limite fortement, l'apprentissage d'un nouveau stimulus présenté simultanément.
Dans notre exemple de Pavlov, supposons que le chien ait déjà appris qu'une sonnerie annonce systématiquement la nourriture : la force associative de la sonnerie atteint alors 1.
a. Si l'on présente ensuite une lumière en même temps que la sonnerie, suivies de la même nourriture, l'erreur de prédiction est :
$(\lambda-\sum V)=1-(1+0)=0$
b. La sonnerie prédit déjà parfaitement la nourriture, tandis que la lumière possède initialement une force associative nulle.
- Puisque l'erreur de prédiction est nulle, la forc
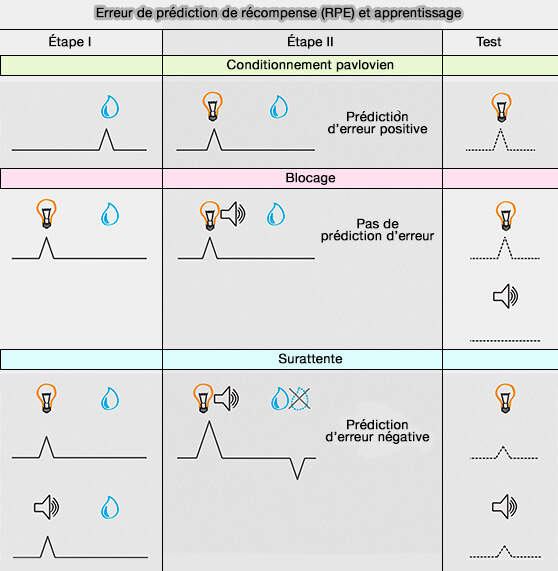 e associative de la lumière ne peut pas augmenter.
- L'apprentissage de l'association entre la lumière et la nourriture est donc bloqué.
Lorsque la lumière est ensuite présentée seule, elle ne provoque pratiquement aucune réponse conditionnée, car elle n'a pas acquis de force associative pendant la deuxième étape de l'apprentissage.
(Figure : vetopsy.fr d'après Nasser et coll)
2. La surattente se produit lorsque deux stimuli, préalablement associés séparément à une récompense, sont ensuite présentés ensemble sans augmentation de cette récompense.
a. Supposons maintenant que le chien ait appris séparément que la sonnerie annonce la nourriture et que la lumière annonce également la nourriture. Chacun des deux stimuli possède alors une force associative de 1.
b. Lorsque la sonnerie et la lumière sont présentées ensemble, suivies d'une seule présentation de nourriture, l'erreur de prédiction devient ::
$(\lambda-\sum V)=1-(1+1)=-1$
- Ensemble, la sonnerie et la lumière prédisent une quantité de nourriture deux fois supérieure à celle effectivement présentée.
- La récompense obtenue étant inférieure à celle prédite par les deux stimuli réunis, la différence entre la récompense obtenue et la récompense prédite est négative.
- Cette erreur de prédiction négative s'accompagne d'une diminution transitoire de l'activité des neurones dopaminergiques au moment de la récompense et entraîne une diminution de la force associative des deux stimuli, afin que leur prédiction corresponde progressivement à la récompense réellement obtenue.
Ces deux phénomènes montrent que, dans le modèle de Rescorla-Wagner, l'apprentissage dépend de l'écart e
Ces deux phénomènes montrent que, dans le modèle de Rescorla-Wagner, l'apprentissage dépend de l'écart entre la valeur prédite par l'ensemble des stimuli présents et celle du résultat obtenu.
Modèle Pearce-Hall (1980)
Le modèle de Pearce-Hall propose que l'associabilité d'un stimulus conditionnel (SC) varie en fonction de l'importance des erreurs de prédiction non signées.
1. Contrairement au modèle de Rescorla-Wagner, qui utilise une erreur de prédiction signée pour modifier la force associative, le modèle de Pearce-Hall utilise la valeur absolue de cette erreur pour ajuster l'associabilité du stimulus, c'est-à-dire sa capacité à faire l'objet d'un nouvel apprentissage.
- Plus le résultat est surprenant, plus l'associabilité du stimulus est élevée.
- À l'inverse, lorsqu'un stimulus prédit correctement le résultat, son associabilité diminue.
2. Reprenons notre exemple du conditionnement classique de Pavlov.
Pour le modèle de Pearce-Hall, nous pouvons utiliser cette équation simplifiée :
$\alpha_{t+1}=|\lambda_t-\sum V_t|$
- $\alpha_{t+1}$ représente l'associabilité du stimulus conditionnel lors de l'essai suivant, avec une valeur comprise entre 0 et 1 dans notre exemple normalisé, mais réévaluée après chaque essai.
- $\lambda_t$ correspond à la valeur de la récompense effectivement obtenue lors de l'essai considéré, soit 1 si la nourriture est présentée et 0 si elle est absente.
- $\sum V_t$ est la valeur totale prédite par les stimuli présents lors de cet essai.
- $|\lambda_t-\sum V_t|$ est la valeur absolue de l'erreur de prédiction, donc une erreur de prédiction non signée, comprise entre 0 et 1 dans nos exemples.
a. Lors des premières présentations de la sonnerie suivie de nourriture, le chien ne prédit pas encore la récompense.
$\alpha_{t+1}=|1-0|=1$
- L'erreur de prédiction est importante.
- Cette surprise maintient une forte associabilité de la sonnerie, ce qui favorise l'apprentissage.
b. Après plusieurs associations, la sonnerie prédit correctement l'arrivée de nourriture.
$\alpha_{t+1}=|1-1|=0$
- L'erreur de prédiction diminue progressivement et devient nulle.
- L'associabilité de la sonnerie diminue également : le chien a moins à apprendre sur ce stimulus puisque ses conséquences sont devenues prévisibles.
c. Le chien entend la sonnerie, mais ne reçoit pas la nourriture attendue.
$\alpha_{t+1}=|0-1|=1$
- Cette omission produit une erreur de prédiction négative $-1$.
- Cependant, c'est sa valeur absolue, 1, qui importe : la surprise augmente à nouveau l'associabilité de la sonnerie, ce qui favorise un nouvel apprentissage.
Modèle Mackintosh (1975)
Le modèle de Mackintosh propose que l'attention portée à un stimulus conditionnel (SC) augmente lorsque celui-ci prédit le résultat plus précisément que les autres stimuli présents.
1. Contrairement au modèle de Pearce-Hall, dans lequel l'associabilité augmente lorsque le résultat est surprenant, le modèle de Mackintosh privilégie les stimuli qui constituent les meilleurs prédicteurs du résultat.
a. Pour le modèle de Mackintosh, nous pouvons utiliser cette équation simplifiée :
$\Delta V_A=\alpha_A\beta(\lambda-V_A)$
- $\Delta V_A$ représente la modification de la force associative du stimulus A.
- $\alpha_A$ représente l'associabilité du stimulus A, comprise entre 0 et 1.
- $\beta$ représente un paramètre d'apprentissage.
- $\lambda$ représente la valeur du résultat obtenu. $V_A$ représente la valeur prédite par le stimulus A.
b. Mais, cette équation ne suffit pas à caractériser Mackintosh car sa particularité réside dans la règle qui fait varier $\alpha_A$. Dans une présentation simplifiée :
- Si le stimulus A prédit le résultat plus précisément que les autres stimuli, son associabilité $\alpha_A$ augmente.
- Si les autres stimuli prédisent mieux le résultat que A, son associabilité diminue.
2. Reprenons notre exemple du conditionnement classique de Pavlov.
- Une sonnerie annonce régulièrement l'arrivée de nourriture et le chien apprend progressivement que la sonnerie constitue un bon prédicteur de cette récompense.
- Si une lumière accompagne également la présentation de nourriture, mais que sa présence est moins fiable que celle de la sonnerie, le chien apprend à privilégier la sonnerie.
Dans le modèle de Mackintosh, l'associabilité de la sonnerie augmente relativement à celle de la lumière, car elle prédit mieux la nourriture.
- À l'inverse, si la lumière devient un meilleur prédicteur de la nourriture que la sonnerie, son associabilité augmente relativement à celle de la sonnerie.
3. Le modèle de Mackintosh repose donc sur la comparaison de la valeur prédictive des stimuli, et non directement sur le signe de l'erreur de prédiction.
Il ne faut notamment pas assimiler les erreurs de prédiction signées étudiées dans les expériences de mémoire épisodique au mécanisme attentionnel proposé par Mackintosh.
Comparaison des trois modèles
- Rescorla-Wagner (1972) : l'erreur de prédiction signée détermine l'augmentation ou la diminution de la force associative d'un stimulus.
- Pearce-Hall (1980) : l'amplitude de l'erreur de prédiction, indépendamment de son signe, détermine l'associabilité du stimulus.
- Mackintosh (1975) : l'associabilité d'un stimulus dépend de sa capacité à prédire le résultat plus précisément que les autres stimuli.
Erreurs de prédiction signées et non signées dans la mémoire
Les erreurs de prédiction signées et non signées interviennent également dans l'encodage de la mémoire épisodique.
Plusieurs études montrent que les différences entre les résultats attendus et les résultats obtenus peuvent influencer la mémorisation des événements, mais leurs effets varient notamment selon le signe de l'erreur et le moment où elle survient.
Erreurs de prédiction signées et mémoire épisodique
1. De nombreuses études ont montré une relation positive entre les erreurs de prédiction signées et l'encodage épisodique (Signed Reward Prediction Errors in the Ventral Striatum Drive Episodic Memory 2021 et The effect of prediction error on episodic memory encoding is modulated by the outcome of the predictions 2023).
Les erreurs de prédiction de récompense (RPE) positives, lorsque la récompense est meilleure que prévu, peuvent favoriser la mémorisation des événements par rapport aux erreurs négatives, lorsque la récompense est moins bonne que prévue.

a. Au cours d'une expérience, un participant apprend qu'une image annonce généralement une récompense de 5 points.
- Si cette image est suivie de 10 points, la récompense est meilleure que prévu et produit une erreur de prédiction positive de +5.
- Si elle est suivie de 0 point, la récompense est moins bonne que prévu et produit une erreur de prédiction négative de −5.
b. Après l'expérience, on présente au participant plusieurs images et on lui demande lesquelles il reconnaît.
On peut ainsi déterminer si les images associées à des erreurs de prédiction positives sont mieux mémorisées que celles associées à des erreurs négatives.
2. Les erreurs de prédiction de récompense (RPE) sont notamment associées aux variations de l'activité des neurones dopaminergiques :
- Leur activité phasique augmente lorsque la récompense est meilleure que prévu.
- Elle diminue lorsque la récompense est moins bonne que prévu.
3. Dans le conditionnement opérant, les choix libres peuvent amplifier les signaux d'erreur de prédiction de récompense par rapport aux essais dans lesquels le participant ne dispose pas de choix.
- Les choix libres, par exemple pouvoir choisir entre plusieurs cartes, pourraient être associés à des signaux d'erreur de prédiction de récompense plus importants (Signed Reward Prediction Errors in the Ventral Striatum Drive Episodic Memory 2021).
- Ce résultat suggère que les régions cérébrales impliquées dans l'actualisation des valeurs attendues au cours de l'apprentissage par renforcement pourraient également participer aux effets des erreurs de prédiction sur l'encodage épisodique.
4. Les erreurs de prédiction de récompense signées pourraient également favoriser la formation de traces mnésiques plus fortes, car la dopamine module la plasticité synaptique de l'hippocampe proprement dit, une structure essentielle à la mémoire épisodique.
- Les interactions entre le striatum et l'hippocampe pourraient contribuer à transmettre les informations relatives aux erreurs de prédiction de récompense et à favoriser l'encodage des événements associés à des erreurs positives (Dopamine and adaptive memory 2010).
- À l'inverse, une diminution de l'activité dopaminergique pourrait réduire la plasticité hippocampique et contribuer à un encodage épisodique moins important lors d'erreurs de prédiction négatives (Midbrain dopamine neurons bidirectionally regulate CA3-CA1 synaptic drive 2015).
Erreurs de prédiction non signées et mémoire épisodique
D'autres études ont rapporté un effet positif des erreurs de prédiction non signées sur l'encodage épisodique (Valence biases in reinforcement learning shift across adolescence and modulate subsequent memory 2022).
1. Un effet positif des PE non signées signifie que les résultats inattendus peuvent améliorer la mémorisation des événements, indépendamment de leur caractère favorable ou défavorable.
Ainsi, une récompense étonnamment élevée ou une récompense étonnamment faible peuvent toutes deux favoriser l'encodage épisodique, car c'est l'amplitude de la surprise qui intervient (Behavioral, Physiological, and Neural Signatures of Surprise during Naturalistic Sports Viewing 2021).
2. Les effets des erreurs de prédiction non signées sur l'encodage épisodique pourraient notamment résulter d'une augmentation de l'attention et de l'activation physiologique (arousal) provoquée par la surprise, conformément au principe du modèle de Pearce-Hall, selon lequel les résultats inattendus augmentent l'associabilité des stimuli, favorisant ainsi leur mémorisation.
3. Le système locus coeruleus/noradrénaline intervient dans les réponses aux changements inattendus des résultats, indépendamment du signe de l'erreur de prédiction (The locus coeruleus and noradrenergic modulation of cognition 2009).
- L'activation du locus coeruleus (LC) pourrait ainsi contribuer à l'augmentation de l'arousal et de l'attention provoquée par la surprise, favorisant l'encodage épisodique.
- Le locus coeruleus peut également libérer de la dopamine dans l'hippocampe, en plus de la noradrénaline.
Cette voie dopaminergique participe notamment à l'apprentissage spatial et à la mémoire (Dopamine release from the locus coeruleus to the dorsal hippocampus promotes spatial learning and memory 2016).
Effets comparés des erreurs de prédiction signées et non signées
Bien que cela puisse paraître paradoxal, la prévisibilité d'un résultat, privilégiée par le modèle de Mackintosh, et la surprise provoquée par un résultat inattendu, privilégiée par le modèle de Pearce-Hall, pourraient toutes deux favoriser la mémoire épisodique par des mécanismes distincts.
1. Les erreurs de prédiction de récompense (RPE) signées et non signées influencent différemment l'apprentissage et la mémorisation des événements (Signed and unsigned reward prediction errors dynamically enhance learning and memory 2021).
- Au moment du signal prédictif, les erreurs de prédiction signées sont associées à une meilleure mémorisation des événements liés aux signaux annonçant une récompense favorable.
Cet effet est compatible avec le modèle de Mackintosh, selon lequel l'attention augmente pour les stimuli qui prédisent efficacement les résultats.
- Au moment de la récompense, les erreurs de prédiction non signées sont associées à une meilleure mémorisation des événements surprenants, que la récompense soit meilleure ou moins bonne que prévu.
Cet effet est compatible avec le modèle de Pearce-Hall, selon lequel l'attention augmente lorsque les résultats sont inattendus.
Remarque : ces résultats sont également à rapprocher de ceux d'une autre étude, qui montre que les erreurs de prédiction positives au cours de la prise de décision renforcent l'encodage mnésique (Positive reward prediction errors during decision making strengthen memory encoding 2019).

Si les études semblent concordantes sur le rôle des erreurs de prédiction signées associées aux signaux prédictifs de récompense dans l'encodage épisodique, leurs résultats sont plus divergents concernant les erreurs de prédiction survenant au moment de la délivrance de la récompense.
2. Les études rapportent :
- des erreurs de prédiction non signées, dont l'amplitude favorise la mémorisation, indépendamment du caractère favorable ou défavorable de la récompense (Dissociable effects of surprising rewards on learning and memory 2018),
- des erreurs de prédiction signées, dont les effets sur la mémorisation dépendent du caractère favorable ou défavorable du résultat obtenu (The effect of prediction error on episodic memory encoding is modulated by the outcome of the predictions 2023 et Signed Reward Prediction Errors in the Ventral Striatum Drive Episodic Memory 2021).
Pourquoi ces contradictions ?
Biais de positivité
Pourquoi apprend-on davantage des résultats positifs de l'option choisie et des résultats négatifs de l'option non choisie, alors que ces erreurs de prédiction peuvent être aussi bien positives que négatives ?
Une des hypothèses avancées pour expliquer les divergences entre les études concerne la possibilité, pour les participants, de choisir eux-mêmes leurs actions dans les tâches instrumentales, contrairement aux tâches pavloviennes où les résultats sont simplement observés.

Vous pouvez lire : Signed and unsigned effects of prediction error on memory: Is it a matter of choice? (2023)
1. Le biais de positivité désigne une tendance à accorder davantage de poids aux informations positives qu'aux informations négatives.
a. Les individus ont notamment tendance à surestimer la probabilité des événements positifs et à sous-estimer celle des événements négatifs (Forming Beliefs: Why Valence Matters 2016).
En d'autres termes, lorsqu'ils forment et actualisent leurs croyances concernant les événements futurs, ils peuvent accorder davantage de poids aux bonnes nouvelles qu'aux mauvaises.
b. Sur le plan algorithmique, ce biais pourrait résulter de l'utilisation de taux d'apprentissage asymétriques dans un modèle d'apprentissage par renforcement (RL, Reinforcement Learning).
Le taux d'apprentissage est alors plus élevé pour les erreurs de prédiction positives que pour les erreurs négatives (Behavioural and neural characterization of optimistic reinforcement learning 2017).
Dans l'équation, $\alpha^+ > \alpha^-$.
Cette asymétrie des taux d'apprentissage a été mise en relation avec l'encodage épisodique (Valence biases in reinforcement learning shift across adolescence and modulate subsequent memory 2022).
Les différences individuelles dans les apprentissages asymétriques pourraient être prédites par l'activité du striatum en réponse aux erreurs de prédiction (PE) lors de la présentation des résultats, au sein des circuits cérébraux de la récompense.
2. Le biais de positivité pourrait en réalité s'expliquer par un biais de confirmation du choix.
Dans les tâches où les participants choisissent entre plusieurs options, il faut distinguer les résultats concernant l'option choisie de ceux concernant l'option non choisie.
Biais de confirmation du choix
Lorsqu'un animal a effectué un choix, apprend-il davantage des résultats qui confirment ce choix que de ceux qui le remettent en question ?
1. Le biais de confirmation du choix désigne la tendance à privilégier les informations qui confortent une décision.
a. Par exemple, si un participant choisit l'option A plutôt que l'option B :
- Si l'option A donne une bonne récompense, ce résultat confirme son choix.
- Si l'option B donne une mauvaise récompense, ce résultat confirme également son choix, puisqu'il a eu raison de ne pas sélectionner B.
b. Ainsi, la confirmation du choix ne dépend pas uniquement du caractère positif ou négatif du résultat, mais aussi de l'option à laquelle il se rapporte.
Les participants semblent ainsi apprendre préférentiellement des erreurs de prédiction qui confirment leurs choix (Choice-Confirmation Bias and Gradual Perseveration in Human Reinforcement Learning 2022 et Decreased transfer of value to action in Tourette syndrome 2020).
2. Dans certaines conditions expérimentales, lorsque les participants ne peuvent pas choisir librement, le biais de positivité disparaît et ils apprennent de manière comparable à partir des résultats positifs et négatifs (Information about action outcomes differentially affects learning from self-determined versus imposed choices 2020).
Confirmation du choix et apprentissage associatif
- Dans les tâches instrumentales, les participants peuvent choisir leurs actions, ce qui favorise l'apparition du biais de confirmation du choix.
- Dans les tâches pavloviennes, les résultats ne dépendent pas de leurs choix. Les erreurs de prédiction positives et négatives pourraient alors avoir des effets plus comparables sur l'apprentissage et la mémoire épisodique.
3. La confirmation du choix pourrait moduler les effets des erreurs de prédiction (PE) sur la mémoire épisodique (The effect of prediction error on episodic memory encoding is modulated by the outcome of the predictions 2023).
a. Dans une tâche sans récompense explicite, les participants devaient prédire l'apparition de différentes catégories d'objets.
- Lorsque leurs attentes étaient faibles mais que leur choix était confirmé, les erreurs de prédiction positives étaient associées à une meilleure mémorisation.
- À l'inverse, lorsque de fortes attentes n'étaient pas confirmées, les erreurs de prédiction négatives étaient associées à une diminution de la mémorisation.
b. Lorsqu'un individu choisit lui-même une action, plutôt que de se la voir imposer, il peut avoir le sentiment de mieux contrôler les résultats, ce qui pourrait favoriser l'encodage épisodique des événements associés à son action (The Simple Act of Choosing Influences Declarative Memory 2015 et Action boosts episodic memory encoding in humans via engagement of a noradrenergic system 2019).
- Lorsque le contrôle perçu est élevé, les individus pourraient attribuer certains résultats négatifs à l'imprévisibilité de l'environnement plutôt qu'à leurs propres choix et ces résultats pourraient alors recevoir moins de poids lors de l'encodage épisodique.
- À l'inverse, lorsque le contrôle perçu est faible, les résultats positifs et négatifs pourraient être mémorisés de manière plus comparable, puisqu'ils sont moins directement associés aux décisions personnelles.
Remarque : les symptômes dépressifs peuvent également modifier les relations entre les erreurs de prédiction et la mémoire épisodique. ( PE et dépression).
Retour aux erreurs de prédiction
En construction