


Erreurs de prédiction
Rôles de la dopamine

Les neurones dopaminergiques signalent les erreurs de prédiction de récompense et participent à l'apprentissage par renforcement, à l'actualisation des valeurs attendues et à l'adaptation des comportements.
Les expériences réalisées chez le singe ont permis de préciser les relations entre l'activité des neurones dopaminergiques et les erreurs de prédiction de récompense (RPE).
L'expérience fondamentale de Schultz illustre comment cette activité évolue au cours de l'apprentissage, selon que la récompense est inattendue, prédite ou omise.

Les rôles respectifs des erreurs de prédiction signées et non signées dans l'apprentissage associatif, aussi bien classique qu'opérant, et la mémoire épisodique sont développés dans une page spécifique.
| Signalisation dopaminergique et erreurs de prédiction de récompense | ||
|---|---|---|
| Forme de signalisation | Caractéristiques | Relation avec les RPE |
| Réponse phasique positive |
Augmentation brève de l'activité dopaminergique |
Récompense meilleure que prévu ou stimulus annonçant une récompense inattendue |
| Réponse phasique négative |
Diminution transitoire de l'activité dopaminergique |
Récompense omise ou moins importante que prévu |
| Réponse à la saillance |
Réponse rapide à un événement pertinent, indépendamment de sa valeur positive ou négative |
Peut accompagner la détection d'un événement inattendu sans coder nécessairement une RPE signée |
| Codage de la valeur attendue |
Activité liée à la valeur prédite des récompenses futures |
Peut apparaître au moment du stimulus prédictif lorsque la valeur attendue change |
| Rampes dopaminergiques |
Augmentation progressive du signal dopaminergique pendant l'approche d'un objectif |
Interprétation en termes de RPE, de valeur ou d'autres variables selon les conditions expérimentales |
| Modulations lentes |
Variations de la disponibilité extracellulaire de dopamine sur des durées plus longues |
Ne correspondent pas nécessairement à des RPE et peuvent intervenir dans la motivation et l'activation comportementale |
Expérience fondamentale : la récompense est-elle attendue ?
Signalisation dopaminergique phasique et tonique
1. La signalisation phasique correspond à des variations rapides et transitoires de l'activité dopaminergique, survenant notamment lors d'événements inattendus ou d'erreurs de prédiction de récompense.
Ces réponses peuvent contribuer à l'apprentissage des relations entre les événements, les actions et leurs conséquences.
2. La signalisation tonique correspond à une activité dopaminergique de fond et à une disponibilité extracellulaire de dopamine évoluant sur des échelles de temps généralement plus longues.
Elle participe à la modulation durable de l'activité des circuits neuronaux et peut intervenir dans la motivation et la vigueur des actions.
Description de l'expérience

Au cours d'un apprentissage, un singe est assis devant deux leviers (A Neural Substrate of Prediction and Reward 1997) :
- l’un est associé à la récompense (R = 1),
- l’autre à aucune récompense (R = 0).
L'activité des neurones dopaminergiques est enregistrée au cours de l'apprentissage afin d'étudier les erreurs de prédiction de récompense (RPE ou Reward Predictive Error).
- Après qu’un stimulus visuel a été présenté, le singe doit appuyer sur le levier gauche afin d’obtenir la récompense sous forme de jus de fruits.
- Si le singe appuie sur le levier de droite, aucune récompense ne lui est délivrée.
1. En début de conditionnement opérant (instrumental), lorsque le singe explore les deux leviers sans encore connaître leurs conséquences, les neurones dopaminergiques présentent une excitation phasique au moment de la récompense.
Cette réponse phasique des neurones dopaminergiques à la récompense a initialement mené à l’hypothèse que la dopamine encode le plaisir associé à la récompense ( liking et plaisir hédonique).
2. Après que le singe a appris le comportement adapté à la tâche, le singe privilégie le levier associé à la récompense.
- L'excitation phasique des neurones dopaminergiques disparaît alors au moment de la récompense et apparaît au moment de la présentation du stimulus prédicteur.
- Pourtant, le plaisir et la motivation associés à la récompense restent présents.
a. L’hypothèse proposée est donc que les neurones dopaminergiques répondent initialement à une récompense inattendue (erreur de prédiction positive).
Au cours de l'apprentissage, leur réponse diminue lorsque la récompense devient prévisible et apparaît lors de la présentation du stimulus visuel qui annonce cette récompense.
b. Ce transfert de l'activité dopaminergique, observé ici au cours d'un conditionnement opérant, est comparable à l'acquisition d'une réponse conditionnée dans le conditionnement classique de Pavlov.
- Sans conditionnement, le stimulus neutre (SN) ne prédit pas l'arrivée de nourriture et ne provoque pas de salivation.
- Lorsque l’animal a appris l'association entre le stimulus conditionnel (SC) et la récompense, stimulus inconditionnel (SI), la présentation du SC déclenche une salivation anticipée, même en l'absence de nourriture.
Remarque : la distinction essentielle est que, dans le conditionnement classique, le chien apprend une association entre deux stimuli, tandis que, dans le conditionnement opérant, le singe apprend la relation entre son action et la récompense.
c. Le transfert de l’activité dopaminergique de la récompense vers le stimulus qui l'annonce a également conduit à interpréter cette activité comme un signal de surprise.
Cependant, ce phénomène s'explique plus précisément par les erreurs de prédiction de récompense (RPE),
Explication de l'expérience par les erreurs de prédiction de récompense (RPE)
L'activité dopaminergique observée au cours de cette expérience peut être expliquée par les erreurs de prédiction de récompense (RPE), conformément aux modèles d'apprentissage par renforcement (Understanding dopamine and reinforcement learning: The dopamine reward prediction error hypothesis 2011).
Cette erreur de prédiction, appelée erreur de différence temporelle (TD error, Temporal Difference ou δt)), est calculée selon l'équation simplifiée suivante (algorithmes d'apprentissage par renforcement) :
$\delta _t=r_{t+1}+\gamma V(t+1)-V(t)$
- $\delta_t$ représente l'erreur de prédiction de récompense associée à la transition entre les instants $t$ et $t+1$.
- $r_{t+1}$ représente la récompense reçue lors de la transition vers l'état suivant.
- $V(t+1)$ représente la valeur estimée des récompenses futures à l'instant $t+1$.
- $V(t)$ représente la valeur estimée des récompenses futures à l'instant $t$.
- $\gamma$ représente le facteur d'actualisation, compris entre 0 et 1, qui détermine l'importance accordée aux récompenses futures.
1. En effet, avant tout conditionnement, l’obtention d’une récompense chez l’animal est inattendue et imprévisible.
a. Aussi, au moment de la récompense (SI), au temps t+1, l’erreur de prédiction vaut :
$\delta _t=r_{t+1}+\gamma V(t+1)-V(t)=1+0-0=+1$
- $r=1$ correspond à la récompense reçue.
- $V(t)=0$ indique que l'animal ne prédit pas de récompense au moment du stimulus neutre (SN),
- $V(t+1)=0$ indique qu'aucune récompense future n'est prédite puisque l'essai est terminé.
b. La récompense reçue alors qu'aucune récompense n'était prédite produit donc une erreur de prédiction positive ($\delta_t=+1$) qui correspond à l'augmentation phasique de l'activité des neurones dopaminergiques observée au moment de la récompense.
À l'absence de prédiction de récompense au moment du stimulus neutre (SN), et \(V(t+1)=0\) à l'absence de récompense future prédite puisque l'essai est terminé.
- $V(t)=V(t+1)=0$, indiquant une prédiction nulle de récompense au moment de la perception du stimulus (SN), ainsi qu’une prédiction de récompense future nulle au moment du SI puisque c’est la fin de l’essai.
- Ce qui permet d’expliquer le pic d’activité au moment de la récompense.
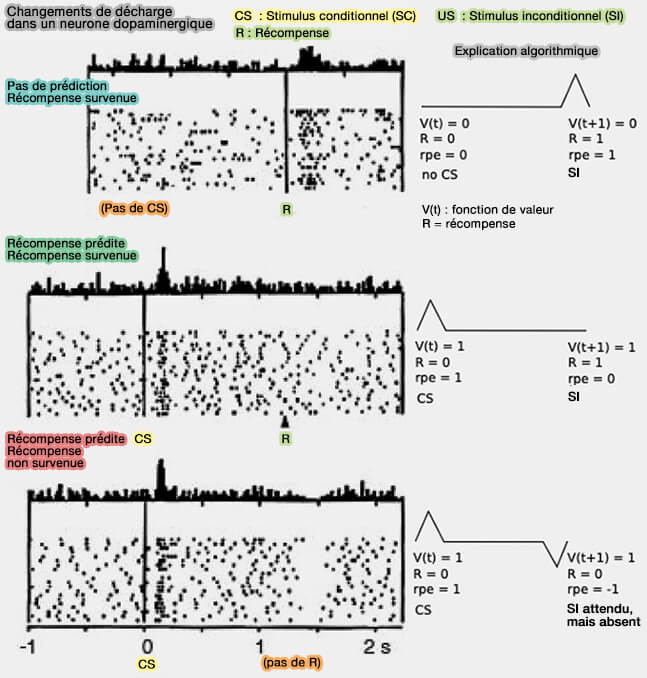
(Figure : vetopsy.fr d'après Schultz)
2. Une fois le conditionnement effectué,
a. au moment du stimulus prédicteur (SC), la RPE vaut :
$\delta_{t-1}=r_t+\gamma V(t)-V(t-1)=0+1-0=+1$
- $r=0$ car aucune récompense n'est encore délivrée.
- $V(t)=0$ correspond à la valeur prédite au début de l'essai, avant la présentation du stimulus.
- $V(t+1)=0$ correspond à la récompense future maintenant prédite par le stimulus ($\gamma=1$).
Ainsi, l’hypothèse de RPE permet d’expliquer pourquoi l’activité du signal dopaminergique est transférée au stimulus conditionnel (SC).
b. Lorsque l’animal reçoit la récompense, aucune activation phasique n'est visible sur les neurones dopaminergiques, traduisant une RPE nulle :
$\delta_{t+1}=r_{t+1}+\gammaV(t+1)-V(t)=1+0-1=0$
- $r=1$ correspond à la récompense reçue.
- V(t)=1$ correspond à la récompense déjà prédite.
- $V(t+1)=0$ correspond à l'absence de récompense future puisque l'essai est terminé.
3. Prenons l'exemple de l'omission d'une récompense. Après apprentissage, l'animal ne reçoit pas la récompense pourtant annoncée par le stimulus conditionnel (SC).
a. Les neurones dopaminergiques présentent une inhibition phasique de leur activité, au moment où la récompense était attendue par l’animal, ce qui correspond à une erreur de prédiction négative.
$\delta_t=r_{t+1}+\gamma V(t+1)-V(t)=0+0-1=-1$
- $r=0$ car la récompense est absente.
- $V(t)=1$ correspond à la récompense qui était prédite.
- $V(t+1)=0$ puisque l'essai est terminé.
b. Encore une fois ce résultat est compatible avec les prédictions de l’apprentissage par renforcement.
Critiques des résultats
1. La principale critique de cette hypothèse repose sur le fait que la réponse phasique des neurones dopaminergiques peut apparaître moins de 100 ms après la présentation d'une récompense.
- Certains chercheurs ont estimé que ce délai était trop court pour permettre aux neurones dopaminergiques de comparer la récompense reçue à la récompense attendue et de coder ainsi une erreur de prédiction de récompense (RPE).
- Ils ont proposé que cette réponse dopaminergique rapide puisse plutôt constituer un signal de détection d'un événement important, favorisant l'orientation de l'attention et l'adaptation du comportement (Is the Short Latency Dopamine Burst Too Short to Signal Reward Error ? 1999).
2. Une autre question concerne la nature du signal dopaminergique, qui pourrait représenter l'erreur de prédiction seule ($\delta_t$) ou sa valeur pondérée par le taux d'apprentissage ($\alpha\delta_t$) ( algorithmes d'apprentissage par renforcement).
3. D'autres critiques ont été émises quant à l’activité dopaminergique au cours de tâches :
- qui font varier les niveaux d’incertitude sur la récompense, afin de déterminer si l'activité dopaminergique dépend uniquement de l'erreur de prédiction ou également de l'incertitude sur le résultat attendu (dopamine, rampe et incertitude),
- qui impliquent un choix de la part de l'animal, afin de déterminer si le signal dopaminergique renseigne uniquement sur l'erreur de prédiction de récompense ou également sur l'action effectuée ( biais de confirmation de choix).
Dopamine, rampe et incertitude :
que se passe-t-il lorsque la récompense est incertaine ?
L'expérience princeps montre que l'activité des neurones dopaminergiques varie selon que la récompense est attendue, inattendue ou omise.
1. D'autres expériences ont étudié cette activité lorsque la récompense est prédite avec différents degrés de probabilité (Discrete Coding of Reward Probability and Uncertainty by Dopamine Neurons 2003).
a. L'expérience de base est l'enregistrement de l’activité dopaminergique de deux singes dans une tâche de conditionnement pavlovien au cours de laquelle cinq stimuli distincts prédisaient la récompense avec une probabilité spécifique, i.e. P = 0, P = 0,25, P = 0,5, P = 0,75, et P = 1.
- Lorsque P = 0.5, l’incertitude concernant l’obtention de la récompense est maximale.
- L’incertitude est nulle dans les conditions P = 0 et P = 1.
b. Les léchages anticipés des animaux montrent que les singes sont capables de distinguer les probabilités de récompense (P) associées aux cinq stimuli.
2. La réponse phasique des neurones dopaminergiques montre une sensibilité importante à la probabilité d’obtenir une récompense prédite par le stimulus.
a. Au moment où les animaux perçoivent le stimulus conditionnel (SC), l’excitation phasique des neurones dopaminergiques reflète la probabilité d’obtention de la récompense.
La réponse dopaminergique est ainsi plus importante lorsque le stimulus prédit avec une probabilité élevée, et plus faible lorsque cette probabilité est faible.
b. Lors de la réception de la récompense, plus celle-ci était prévisible, moins la réponse des neurones dopaminergiques à la récompense était importante.
L'information encodée par les neurones dopaminergiques est cohérente avec les erreurs de prédiction de récompense (RPE) calculées par les algorithmes TD, aussi bien au moment de la présentation du stimulus qu'à celui de la réception de la récompense .
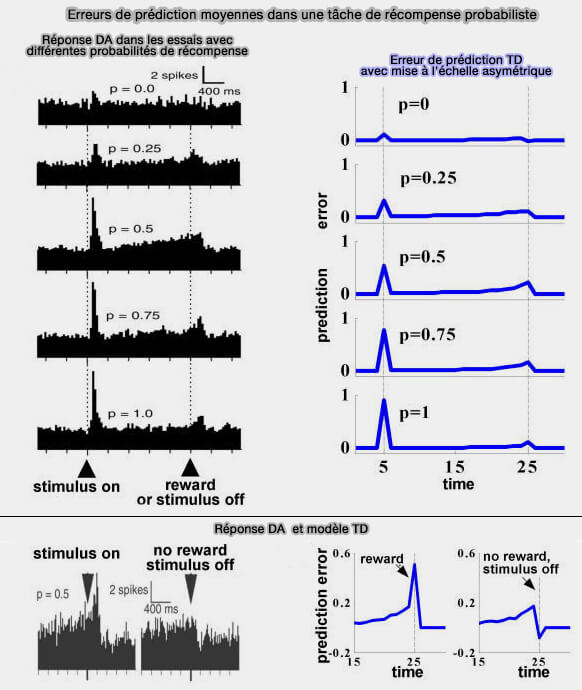
(Figure : vetopsy.fr d'après les expériences de Schultz)
3. Toutefois, dans les modèles d'apprentissage par différence temporelle (TD), en l'absence de nouvelle information, l'erreur de prédiction de récompense $\delta_t$ devrait être nulle entre la présentation du stimulus et le moment attendu de la récompense.
$\delta _t=r_{t+1}+\gamma V(t+1)-V(t)$
or, $r=0$, puisqu'aucune récompense n'est reçue, $\gamma V(t+1)=V(t)$, si la prédiction est exacte., donc $\delta_t=0$
a. Or, l'activité des neurones dopaminergiques entre la présentation du SC et le moment attendu de la récompense présente une augmentation progressive, appelée " rampe dopaminergique ", dont l'amplitude varie, selon l'étude de Fiorillo, avec l'incertitude de la récompense (Discrete Coding of Reward Probability and Uncertainty by Dopamine Neurons 2003).
- Si la récompense (P = 1) ou l’absence de récompense (P = 0) est prédite avec certitude, cette rampe n’est pas présente.
- Si l’incertitude est maximale (P = 0.5), cette rampe est bien visible.
- Si l’incertitude intermédiaire (P = 0.25 ou P = 0.75), la rampe est d’amplitude intermédiaire.
b. La distinction essentielle est que le modèle TD classique ne prédit pas cette augmentation progressive en l'absence de nouvelle information, alors que Fiorillo observe une activité croissante pendant l'attente de la récompense.
4. Cet effet de rampe a été examiné dans une étude qui propose de l'expliquer par l'encodage asymétrique des erreurs de prédiction de récompense (RPE) positives et négatives, lié à la faible activité tonique des neurones dopaminergiques (Dopamine, uncertainty and TD learning 2005).
a. Dans les modèles d'apprentissage par différence temporelle (TD), les erreurs de prédiction positives et négatives correspondent respectivement à des augmentations et à des diminutions de l'activité dopaminergique par rapport à son niveau de base.
- Les cellules dopaminergiques ont une activité de base très faible, ce qui implique que la représentation de ces deux types d’erreurs est asymétrique.
- En effet, l’activité tonique des neurones dopaminergiques est d’environ 5Hz, ce qui empêche ces neurones d’encoder une erreur de prédiction négative avec la même variation d’amplitude qu’une erreur de prédiction positive.
- Une excitation phasique des neurones dopaminergiques peut atteindre une amplitude jusqu'à six fois supérieure à celle de l'inhibition observée lors d'une omission de récompense.
b. Cette asymétrie pourrait produire une augmentation apparente de l'activité dopaminergique moyenne pendant l'attente de la récompense, sans nécessiter un signal spécifique d'incertitude.
Cette interprétation repose sur les variations de l'activité dopaminergique au cours des essais et sur l'influence des récompenses obtenues précédemment (Midbrain Dopamine Neurons Encode a Quantitative Reward Prediction Error Signal 2005).
c. Cette asymétrie a conduit à proposer d'autres mécanismes pour l'encodage des erreurs de prédiction négatives, qui pourraient être représentées :
- par la sérotonine (Opponent interactions between serotonin and dopamine 2002),
- par la durée de l’inhibition dopaminergique et non son amplitude (Statistics of Midbrain Dopamine Neuron Spike Trains in the Awake Primate 2007).
5. D'autres études proposent des interprétations différentes de la rampe dopaminergique.
- La rampe d’activité enregistrée ne serait pas directement liée à l'incertitude, mais à la proximité et à la valeur de la récompense (Prolonged Dopamine Signalling in Striatum Signals Proximity and Value of Distant Rewards 2013)..
Elle pourrait ainsi refléter un signal motivationnel plutôt qu'une erreur de prédiction de récompense.
- Cette rampe d’activité pourrait également être expliquée dans le cadre de l’encodage des RPE, en tenant compte de la progression de l'animal vers la récompense (Dopamine ramps are a consequence of reward prediction errors 2013).
Rôle causal de la dopamine dans l'apprentissage par renforcement
L’activité dopaminergique phasique peut être corrélée aux erreurs de prédiction de récompense (RPE) selon de nombreuses expérimentations sur l'apprentissage qui sont résumées ici (The Dopamine Prediction Error: Contributions to Associative Models of Reward Learning 2017).
1. L'amplitude de l'activité phasique est en corrélation avec la grandeur de l'erreur de prédiction positive (Dopamine Neuron-Specific Optogenetic Stimulation in Rhesus Macaques 2014 et Dopamine neurons share common response function for reward prediction error 2016).
Les réponses dopaminergiques peuvent également varier selon plusieurs dimensions de la récompense et de la décision :
- la valeur subjective de la récompense,
- la valeur de l'action future,
- l'incertitude de la récompense,
- la valeur de la meilleure option disponible, qui ne correspond pas nécessairement à celle choisie par l'animal.
2. Les expériences d'optogénétique permettent de démontrer le rôle causal de l'activité des neurones dopaminergiques dans l'apprentissage par renforcement.
En activant ou en inhibant ces neurones à des moments précis, les chercheurs peuvent reproduire les effets des erreurs de prédiction positives ou négatives et évaluer leur contribution causale à l'apprentissage.
- La stimulation des neurones dopaminergiques de l'aire tegmentale ventrale (VTA) peut imiter une erreur de prédiction positive et favoriser l'apprentissage (A Causal Link Between Prediction Errors, Dopamine Neurons and Learning 2013)
- La suppression transitoire de l'activité des neurones dopaminergiques est suffisante pour imiter une erreur de prédiction négative (Brief optogenetic inhibition of dopamine neurons mimics endogenous negative reward prediction errors 2016).
Remarque : chez le macaque rhésus, la stimulation optogénétique des neurones dopaminergiques au moment de la récompense favorise également l'apprentissage et augmente la préférence pour le stimulus associé à cette stimulation (Dopamine Neuron-Specific Optogenetic Stimulation in Rhesus Macaques 2016).
Ces études confirment que l'activité phasique des neurones dopaminergiques peut produire des signaux d'erreur de prédiction positifs ou négatifs et influencer directement l'apprentissage.
Dopamine et valeur
Dopamine et valeur cumulée des récompenses futures
L'activité des neurones dopaminergiques peut-elle refléter la valeur cumulée de plusieurs récompenses futures, même lorsqu'elles ne sont pas immédiatement reçues ?
Trois singes qui ont effectué une tâche de choix en plusieurs étapes dans laquelle ils ont exploré une cible de récompense parmi des alternatives (Dopamine neurons learn to encode the long-term value of multiple future rewards 2011).
- Puis, ils ont exploité ces connaissances pour recevoir une ou deux récompenses supplémentaires en choisissant la même cible dans une série d'essais ultérieurs.
- Une analyse du léchage anticipé pour obtenir de l'eau de récompense a indiqué que les singes n'anticipaient pas une récompense immédiatement attendue dans les essais individuels, ils anticipaient plutôt la somme des récompenses immédiates et futures multiples.
- L'activité des neurones dopaminergiques reflétait la valeur cumulée des récompenses immédiates et futures attendues, et non seulement celle de la prochaine récompense.
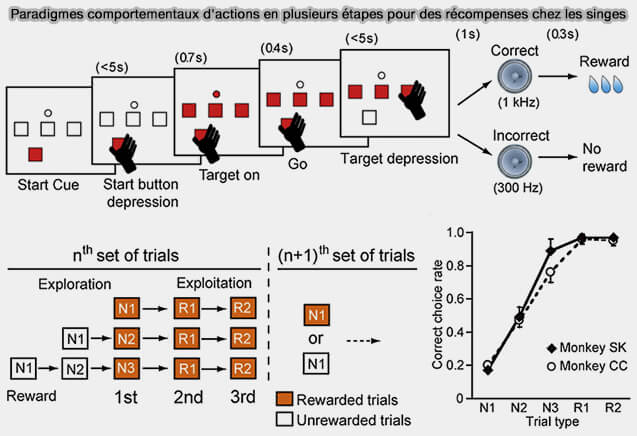
(Figure : vetopsy.fr d'après Enomoto et coll)
1. Ces résultats montrent que les neurones dopaminergiques peuvent anticiper la valeur cumulée de plusieurs récompenses futures, tout en conservant un signal compatible avec les erreurs de prédiction de récompense (RPE) (Dopamine prediction error responses integrate subjective value from different reward dimensions 2014).
a. En effet, au moment de la présentation du stimulus prédictif :
- Avant le stimulus, aucune récompense n'est encore prédite : $V(t-1)=0$.
- Le stimulus annonce trois récompenses futures, dont la valeur cumulée est représentée par $V(t)=3$.
- Aucune récompense n'est encore reçue : $r_t=0$.
b. En supposant que le facteur d'actualisation temporelle $\gamma=1$, l'erreur de prédiction est donc :
$\delta_t=r_t+\gamma V(t)-V(t-1)=0+3-0=3=V(t)$
c. Dans ces conditions particulières, l'erreur de prédiction de récompense (RPE) $\delta_t$ représente la valeur attendue $V(t)$, et non à la valeur des récompenses effectivement reçues.
- Ainsi, les neurones dopaminergiques peuvent augmenter leur activité dès l'annonce des récompenses, avant leur réception.
- Cette augmentation traduit ici une erreur de prédiction positive, puisque la valeur attendue passe brusquement de zéro à trois.
Remarque : le calcul présenté constitue un exemple simplifié destiné à expliquer le mécanisme.
- Il suppose qu'avant la présentation du stimulus, aucune récompense n'est attendue ($V(t-1)=0$) et que le facteur d'actualisation temporelle est égal à 1 ($\gamma=1$).
- Ces conditions ne sont pas nécessairement réunies au début de chaque essai de l'expérience d'Enomoto, puisque les singes ont déjà appris à anticiper les récompenses.
Dopamine et valeur des récompenses lors des choix
Lorsque l'animal doit choisir entre deux récompenses différentes, l'activité des neurones dopaminergiques reflète-t-elle la valeur de l'option qu'il va choisir ou celle de la meilleure option disponible, indépendamment de son choix ?
1. Pour déterminer si l'activité dopaminergique dépend du choix futur de l'animal, les chercheurs ont comparé deux situations :
- des essais dits choix forcés, dans lesquels seule une option est récompensée,
- des essais dits choix libre, dans lesquels les deux options sont associées à une récompense différente et dans lesquels l’animal apprendra à faire le meilleur choix parmi ces deux options pour maximiser sa récompense.
Différentes études ont été effectuées sur :
- des rats (Phasic nucleus accumbens dopamine release encodes effort and delay related costs 2011 et Dissociable cost and benefit encoding of future rewards by mesolimbic dopamine 2010 et Dopamine neurons encode the better option in rats deciding between differently delayed or sized rewards 2007),
- des singes (Midbrain dopamine neurons encode decisions for future action 2006).
2. Les résultats de ces études divergent quant à l'influence du choix futur de l'animal sur l'activité des neurones dopaminergiques.
- Dans certaines expériences, cette activité reflète la valeur de l'option que l'animal va choisir, tandis que dans d'autres, elle reflète la valeur de la meilleure option disponible, indépendamment du choix effectué.
- Ces différences pourraient notamment s'expliquer par les conditions expérimentales, telles que l'espèce étudiée, la nature des récompenses ou les stimuli conditionnels (SC) utilisés.
Ainsi, le codage dopaminergique de la valeur ne dépend pas nécessairement du choix futur de l'animal et peut varier selon le contexte expérimental.
Bases neuroanatomiques des erreurs de prédiction dopaminergiques
1. Les neurones dopaminergiques de l'aire tegmentale ventrale (VTA), mais aussi ceux de la substance noire compacte (SNc), peuvent signaler des erreurs de prédiction de récompense ou RPE (A Neural Substrate of Prediction and Reward 1997).
1. Les neurones dopaminergiques de l'aire tegmentale ventrale (VTA), mais aussi ceux de la substance noire compacte (SNc), peuvent signaler des erreurs de prédiction de récompense ou RPE (A Neural Substrate of Prediction and Reward 1997).
Ces signaux dopaminergiques participent à l'apprentissage par renforcement en modulant les circuits du striatum (Segregation of D1 and D2 dopamine receptors in the striatal direct and indirect pathways: An historical perspective 2023) :
- par la voie directe, une augmentation de dopamine favorise le renforcement des actions associées à une récompense meilleure que prévu (erreur de prédiction positive),
- par la voie indirecte, une diminution de dopamine peut favoriser l'apprentissage de l'évitement des actions associées à une récompense moins bonne que prévu (erreur de prédiction négative).
2. Le striatum reçoit des informations qui lui permettent d'associer les signaux de récompense aux actions et aux objectifs de l'animal (Striatal Dopamine Signals and Reward Learning 2023).
a. Les ganglions de la base (noyaux gris centraux) participent à l'intégration d'informations motivationnelles, affectives, cognitives et motrices provenant de nombreuses structures corticales, limbiques et sous-corticales (modèle actuel de la connectivité).
Ils contribuent ainsi à la sélection et à l'adaptation des représentations, des objectifs et des actions en fonction des informations disponibles.

(Figure : vetopsy.fr
b. Les différentes régions du striatum possèdent des circuits neuronaux organisés de manière similaire et les différences fonctionnelles résultent notamment de la nature des informations reçues et des structures auxquelles les circuits striataux transmettent leurs sorties (The hippocampal–striatal axis in learning, prediction and goal-directed behavior 2011).
- Dans le striatum dorsolatéral, les informations provenant des aires sensorimotrices contribuent notamment à l'apprentissage et à la sélection des actions.
- Dans le noyau accumbens (Nac), les informations provenant des structures limbiques et corticales sont intégrées avec les signaux dopaminergiques pour permettre aux valeurs apprises et aux états motivationnels d'influencer le comportement.
- Les projections glutamatergiques issues du subiculum et de la région CA1 de l'hippocampe proprement dit, ainsi que du cortex préfrontal médial (mPFC), comprenant les régions prélimbique et infralimbique chez les rongeurs, convergent vers le Nac et lui lui transmettent des informations contextuelles et des prédictions susceptibles de moduler l'activité de ses neurones (Reward integration in prefrontal-cortical and ventral-hippocampal nucleus accumbens inputs cooperatively modulates engagement 2025).
c. Les circuits striataux participent ainsi à l'utilisation des erreurs de prédiction pour modifier les valeurs apprises et orienter les comportements futurs.
Retour aux erreurs de prédiction
En construction